실행 관찰 실습
B에서 사용할 환경 설정, 합계 프로그램, 제출·검사 코드 5개입니다.
실행 관찰 ZIP 받기CHAPTER 03 · 분산처리와 Spark 실행 원리
1부터 100까지의 합을 여러 계산 자원에 나누어 구합니다. 환경과 전체 코드를 확인하고, 데이터가 나뉘고 합쳐지는 과정을 배웁니다. Worker와 코어 수를 바꾸어 실행 구조와 처리 시간을 비교합니다.
환경과 전체 코드를 먼저 확인한 뒤, 분산 처리 원리와 코드의 역할을 차례로 읽습니다.
실행 환경과 파일을 준비하고 전체 코드의 흐름을 확인합니다. 각 줄의 역할은 이어지는 절에서 설명합니다.
B에서 사용할 환경 설정, 합계 프로그램, 제출·검사 코드 5개입니다.
실행 관찰 ZIP 받기C에서 사용할 환경 설정, 시간 측정 프로그램, 제출 코드 3개입니다.
성능 비교 ZIP 받기두 ZIP을 같은 대상 폴더에 압축 해제하면 BigData/실습자료 아래에 두 실습 폴더가 나란히 생깁니다. 압축 파일 안에서 바로 실행하지 말고 먼저 전체 압축을 푸세요.
두 ZIP을 내려받은 폴더의 PowerShell에서 다음 명령을 실행해도 됩니다. 새 spark-labs 폴더를 만든 뒤 이 장의 시작 위치인 BigData로 이동합니다.
Expand-Archive .\spark-execution-lab.zip -DestinationPath .\spark-labs
Expand-Archive .\spark-performance-lab.zip -DestinationPath .\spark-labs
cd .\spark-labs\BigDataspark:4.1.3-scala2.13-java21-python3-ubuntu를 사용합니다. Java·Python·Spark는 이 이미지 안에서 실행하므로 이 실습을 위해 Windows에 따로 설치하지 않습니다. 이미지가 없으면 최초 다운로드에 인터넷이 필요합니다..sh 파일의 줄바꿈은 LF로 지정하세요.ZIP의 압축을 풀면 아래 구조가 만들어집니다. 기존 학습 폴더가 있다면 해당 파일을 그대로 사용할 수 있습니다. 개별 파일을 받는 경우에도 같은 구조로 저장하세요.
이름이 같은 두 compose.yaml은 용도가 다르므로 각각의 폴더에 둡니다.
BigData/
└─ 실습자료/
   ├─ 2장_실습자료/          # 1~100 합계와 실행 구조 관찰
   │  ├─ compose.yaml
   │  └─ apps/
   │     ├─ run.sh
   │     ├─ first_app.py
   │     ├─ check_pyspark.py
   │     └─ check_network.py
   └─ 3장_실습자료/          # 큰 입력의 성능 비교
      ├─ compose.yaml
      └─ apps/
         ├─ run_performance.sh
         └─ performance_app.py
명령에서 말하는 BigData 폴더는 위 구조에서 실습자료를 바로 포함하는 폴더입니다. 파일 탐색기로 이 폴더를 연 뒤 주소창에 powershell을 입력하고 Enter를 누르면 해당 위치에서 시작할 수 있습니다.
합계 실습은 코드가 숫자를 생성하므로 별도 입력 파일이 필요하지 않습니다. 단어 집계의 세 줄 예시는 표의 변화를 설명하며, 실행용 입력 파일은 해당 절의 보충 실습에서 받습니다.
| 목적 | 실행 폴더 | 브라우저 주소 |
|---|---|---|
| 1~100 합계와 실행 구조 관찰 | 실습자료/2장_실습자료 | Master localhost:8080Driver localhost:4040 |
| Worker·코어 수에 따른 성능 비교 | 실습자료/3장_실습자료 | Master localhost:18080Driver localhost:24040 |
Master는 사용할 계산 자원을 관리하고, Worker는 그 자원을 제공합니다. Driver는 제출한 프로그램의 계산을 지휘합니다. 각 역할과 화면의 의미는 뒤에서 차례로 설명합니다.
아래는 내려받을 파일과 같은 전체 내용입니다. 두 실습 모두 환경 설정 → 제출 스크립트 → 계산 코드 순서로 읽습니다. 각 파일의 역할은 이어지는 절에서 설명합니다.
compose.yamlSpark를 실행할 컨테이너와 연결 주소를 정합니다. 두 Worker로 시작하는 명령은 뒤의 실행 준비에서 안내합니다.
name: bigdata-week02

x-spark: &spark
  image: spark:4.1.3-scala2.13-java21-python3-ubuntu
  environment:
    PYSPARK_PYTHON: python3
  init: true
  stop_grace_period: 30s

services:
  spark-master:
    <<: *spark
    hostname: spark-master
    entrypoint: ["/opt/spark/bin/spark-class"]
    command: ["org.apache.spark.deploy.master.Master", "--host", "spark-master", "--port", "7077", "--webui-port", "8080"]
    ports:
      - "127.0.0.1:8080:8080"
    healthcheck:
      test: ["CMD", "python3", "-c", "import urllib.request; urllib.request.urlopen('http://localhost:8080', timeout=3)"]
      interval: 5s
      timeout: 5s
      retries: 20
      start_period: 20s

  spark-worker-1:
    <<: *spark
    hostname: spark-worker-1
    entrypoint: ["/opt/spark/bin/spark-class"]
    command: ["org.apache.spark.deploy.worker.Worker", "--host", "spark-worker-1", "--cores", "1", "--memory", "1g", "--webui-port", "8081", "--work-dir", "/tmp/spark-work", "spark://spark-master:7077"]
    ports:
      - "127.0.0.1:8081:8081"
    depends_on:
      spark-master:
        condition: service_healthy

  spark-worker-2:
    <<: *spark
    hostname: spark-worker-2
    entrypoint: ["/opt/spark/bin/spark-class"]
    command: ["org.apache.spark.deploy.worker.Worker", "--host", "spark-worker-2", "--cores", "1", "--memory", "1g", "--webui-port", "8081", "--work-dir", "/tmp/spark-work", "spark://spark-master:7077"]
    ports:
      - "127.0.0.1:8082:8081"
    depends_on:
      spark-master:
        condition: service_healthy

  spark-client:
    <<: *spark
    hostname: spark-client
    entrypoint: ["/bin/bash", "-lc"]
    command: ["exec sleep infinity"]
    ports:
      - "127.0.0.1:4040:4040"
    volumes:
      - ./apps:/opt/spark/apps:ro
    depends_on:
      spark-master:
condition: service_healthyapps/run.shPython 프로그램을 Spark에 제출하는 Bash 스크립트입니다. 전체 코어 상한을 2로 지정합니다.
#!/usr/bin/env bash
set -euo pipefail
exec /opt/spark/bin/spark-submit \
  --master spark://spark-master:7077 \
  --deploy-mode client \
  --driver-memory 512m \
  --executor-memory 512m \
  --executor-cores 1 \
  --total-executor-cores 2 \
  --conf spark.dynamicAllocation.enabled=false \
  --conf spark.driver.host=spark-client \
  --conf spark.driver.bindAddress=0.0.0.0 \
  --conf spark.driver.port=39000 \
  --conf spark.blockManager.port=39001 \
/opt/spark/apps/first_app.py "$@"apps/first_app.py1부터 100까지의 합을 5050과 비교하고, 실행 상태를 볼 수 있도록 잠시 기다린 뒤 종료합니다.
"""Week 2: submit, verify a known answer, observe the UI, and stop."""
import argparse
import time
from pyspark.sql import SparkSession

parser = argparse.ArgumentParser()
parser.add_argument("--wait-seconds", type=int, default=120)
args = parser.parse_args()

spark = SparkSession.builder.appName("Week02-First-App").getOrCreate()
try:
    spark.sparkContext.setLogLevel("WARN")
    print(f"MASTER={spark.sparkContext.master}", flush=True)
    print(f"APP_ID={spark.sparkContext.applicationId}", flush=True)
    assert spark.sparkContext.master == "spark://spark-master:7077"

    # Four input partitions. DataFrame syntax is covered next week.
    numbers = spark.range(1, 101, 1, 4)
    total = numbers.selectExpr("sum(id) AS total").first()["total"]
    print(f"SUM_1_TO_100={total}", flush=True)
    assert total == 5050, f"Unexpected result: {total}"
    print("CHECK=PASS", flush=True)
    print(f"UI observation: {max(0, args.wait_seconds)} seconds", flush=True)
    time.sleep(max(0, args.wait_seconds))
finally:
    spark.stop()
print("APP_STOPPED", flush=True)apps/check_pyspark.py컨테이너 안의 PySpark 버전과 간단한 로컬 계산을 확인합니다.
import pyspark
from pyspark.sql import SparkSession

print(f"PYSPARK_VERSION={pyspark.__version__}", flush=True)
assert pyspark.__version__ == "4.1.3"
spark = SparkSession.builder.appName("Week02-Image-Check").getOrCreate()
try:
    assert spark.range(1).count() == 1
    print("PYSPARK_IMAGE_CHECK=PASS", flush=True)
finally:
spark.stop()apps/check_network.py서비스 이름을 주소로 찾을 수 있는지, 필요한 통신 포트에 연결할 수 있는지 확인합니다.
"""Run after all four Compose services have started. No extra container needed."""
import socket
import sys

names = ("spark-master", "spark-worker-1", "spark-worker-2", "spark-client")
failures = 0
for name in names:
    try:
        print(f"DNS {name} -> {socket.gethostbyname(name)}", flush=True)
    except OSError as exc:
        failures += 1
        print(f"DNS_FAIL {name}: {exc}", flush=True)

for name, port in (("spark-master", 7077), ("spark-worker-1", 8081), ("spark-worker-2", 8081)):
    try:
        with socket.create_connection((name, port), timeout=3):
            print(f"TCP {name}:{port} -> OK", flush=True)
    except OSError as exc:
        failures += 1
        print(f"TCP_FAIL {name}:{port}: {exc}", flush=True)

print("NETWORK_CHECK=" + ("PASS" if failures == 0 else "FAIL"), flush=True)
print("TCP success alone does not verify Spark registration or application correctness.")
sys.exit(0 if failures == 0 else 1)compose.yamlWorker를 1·2·4·8개로 복제할 수 있는 환경을 만듭니다. 실행 관찰용 설정과 별도 폴더에 저장합니다.
name: bigdata-week03-scale

x-spark: &spark
  image: spark:4.1.3-scala2.13-java21-python3-ubuntu
  environment:
    PYSPARK_PYTHON: python3
  init: true
  stop_grace_period: 30s

services:
  spark-master:
    <<: *spark
    hostname: spark-master
    entrypoint: ["/opt/spark/bin/spark-class"]
    command: ["org.apache.spark.deploy.master.Master", "--host", "spark-master", "--port", "7077", "--webui-port", "8080"]
    ports:
      - "127.0.0.1:18080:8080"
    healthcheck:
      test: ["CMD", "python3", "-c", "import urllib.request; urllib.request.urlopen('http://localhost:8080', timeout=3)"]
      interval: 5s
      timeout: 5s
      retries: 20
      start_period: 20s

  spark-worker:
    <<: *spark
    entrypoint: ["/bin/bash", "-lc"]
    command:
      - >-
        exec /opt/spark/bin/spark-class
        org.apache.spark.deploy.worker.Worker
        --host "$$HOSTNAME"
        --cores 1
        --memory 1g
        --webui-port 8081
        --work-dir /tmp/spark-work
        spark://spark-master:7077
    depends_on:
      spark-master:
        condition: service_healthy

  spark-client:
    <<: *spark
    hostname: spark-client
    entrypoint: ["/bin/bash", "-lc"]
    command: ["exec sleep infinity"]
    ports:
      - "127.0.0.1:24040:4040"
    volumes:
      - ./apps:/opt/spark/apps:ro
    depends_on:
      spark-master:
condition: service_healthyapps/run_performance.sh이번 프로그램이 사용할 전체 코어 상한을 환경변수로 받아 전달합니다.
#!/usr/bin/env bash
set -euo pipefail

TOTAL_EXECUTOR_CORES="${TOTAL_EXECUTOR_CORES:-1}"

exec /opt/spark/bin/spark-submit \
  --master spark://spark-master:7077 \
  --deploy-mode client \
  --driver-memory 512m \
  --executor-memory 512m \
  --executor-cores 1 \
  --total-executor-cores "${TOTAL_EXECUTOR_CORES}" \
  --conf spark.dynamicAllocation.enabled=false \
  --conf spark.driver.host=spark-client \
  --conf spark.driver.bindAddress=0.0.0.0 \
  --conf spark.driver.port=39000 \
  --conf spark.blockManager.port=39001 \
/opt/spark/apps/performance_app.py "$@"apps/performance_app.py같은 합계를 반복 계산해 정답을 검사하고, 각 실행 시간과 중앙값을 출력합니다.
"""Measure the same Spark aggregation with different cluster resources."""

import argparse
import statistics
import time

from pyspark.sql import SparkSession


parser = argparse.ArgumentParser()
parser.add_argument("--end", type=int, default=1_000_000_001)
parser.add_argument("--partitions", type=int, default=128)
parser.add_argument("--repetitions", type=int, default=3)
parser.add_argument("--wait-seconds", type=int, default=0)
args = parser.parse_args()

if args.end <= 1:
    parser.error("--end must be greater than 1")
if args.partitions <= 0:
    parser.error("--partitions must be greater than 0")
if args.repetitions <= 0:
    parser.error("--repetitions must be greater than 0")

spark = SparkSession.builder.appName("Week03-Scaling-Experiment").getOrCreate()

try:
    spark.sparkContext.setLogLevel("WARN")
    print(f"MASTER={spark.sparkContext.master}", flush=True)
    print(f"APP_ID={spark.sparkContext.applicationId}", flush=True)
    print(f"RANGE=1..{args.end - 1}", flush=True)
    print(f"PARTITIONS={args.partitions}", flush=True)
    print(f"REPETITIONS={args.repetitions}", flush=True)

    numbers = spark.range(1, args.end, 1, args.partitions)
    expected = (args.end - 1) * args.end // 2
    elapsed_values = []

    for run_number in range(1, args.repetitions + 1):
        started = time.perf_counter()
        total = numbers.selectExpr("SUM(id) AS total").first()["total"]
        elapsed = time.perf_counter() - started

        assert total == expected, f"Unexpected result: {total}"
        elapsed_values.append(elapsed)
        print(f"RUN_{run_number}_SECONDS={elapsed:.3f}", flush=True)

    median_seconds = statistics.median(elapsed_values)
    print(f"SUM_RESULT={total}", flush=True)
    print(f"MEDIAN_SECONDS={median_seconds:.3f}", flush=True)
    print("CHECK=PASS", flush=True)
    print(f"UI observation: {max(0, args.wait_seconds)} seconds", flush=True)
    time.sleep(max(0, args.wait_seconds))
finally:
    spark.stop()

print("APP_STOPPED", flush=True)
제공 실습: 실행 관찰용 파일 5개와 성능 비교용 파일 3개. 환경 참고: Docker Desktop Windows 설치 · Spark 프로그램 제출.
분산처리는 큰 데이터를 나누어 여러 계산 자원이 함께 처리하는 방식입니다. 한 컴퓨터의 용량이나 처리 속도가 부족할 때 필요합니다.
시험지 네 묶음을 조교 두 명이 채점하면, 두 묶음은 처리하고 나머지는 기다립니다. 데이터 조각 수와 동시에 일할 자원 수는 다릅니다.
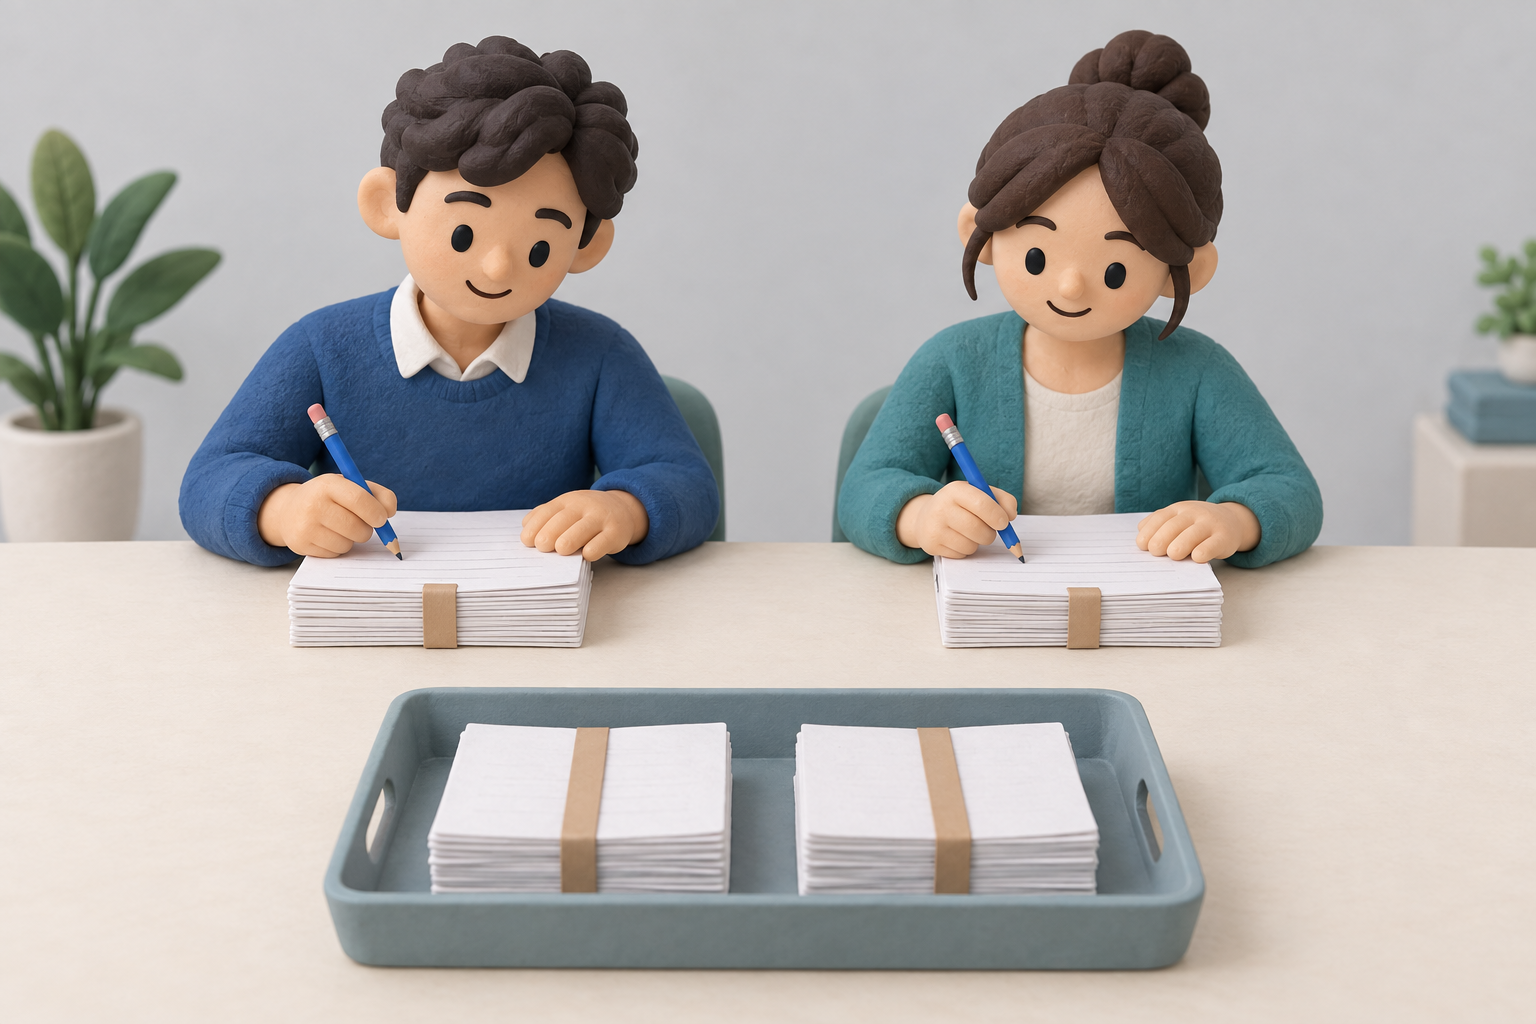
여러 컴퓨터의 자원을 쓰면 용량과 처리량을 늘리고, 실패한 작업 일부를 다시 실행하도록 설계할 수 있습니다.
| 방법 | 실제 구조 | 제약 |
|---|---|---|
| Scale-up · 한 대 강화 | 한 컴퓨터의 CPU와 메모리를 늘립니다. 실습에서는 기존 계산용 컨테이너의 자원 설정 증가에 대응합니다. | 장비 한 대가 지원하는 용량과 비용에 한계가 있습니다. |
| Scale-out · 대수 증가 | 컴퓨터를 추가하고 작업을 나눕니다. 실습에서는 Worker 컨테이너 수를 늘려 구조를 관찰합니다. | 통신, 작업 배정, 결과 모으기와 장애 처리가 필요합니다. |
Task(태스크)는 데이터 조각 하나를 처리하는 작업입니다. 이번 실습처럼 Task 하나가 코어 하나를 쓰면, 동시 실행 상한은 준비된 Task 수와 사용 가능한 코어 수 중 작은 값입니다.
모든 컨테이너는 같은 Windows PC의 CPU와 메모리를 공유합니다. 여러 물리 서버의 성능·장애 환경과는 다릅니다. 작은 데이터는 분산처리 준비 비용 때문에 단일 프로세스가 더 빠를 수도 있습니다.
출처: 3장 「분산처리와 Spark 실행 원리」 슬라이드 1–8 (파일 순서 기준).
Apache Spark는 작업 배정과 데이터 이동을 관리하며 분산 계산을 실행하는 처리 엔진입니다. 수업에서는 Python으로 Spark를 사용하는 PySpark를 씁니다.
파일 저장소가 재료를 보관하는 창고라면, Spark는 재료를 가공하는 조리실에 해당합니다. 저장과 계산의 역할을 구분하는 비유입니다.
Hadoop의 MapReduce는 모아 둔 데이터를 한 번에 처리하는 대규모 Batch(배치) 방식입니다. 반복 분석에서 데이터를 다시 읽고 중간 결과를 디스크에 쓰는 비용을 줄이려는 요구가 Spark의 배경이 되었습니다.
강의 연혁: 2009년 UC Berkeley AMPLab에서 시작 → 2010년 공개 → 2014년 Apache 최상위 프로젝트 승격.
| 역할 | 강의에 나온 예 | Spark와의 관계 |
|---|---|---|
| 수집 | Kafka, 파일, CDC(데이터 변경 수집) | 처리할 입력을 제공합니다. |
| 저장 | HDFS(분산 파일 시스템), 객체 저장소, Iceberg·Delta와 같은 표 관리 기술 | Spark가 데이터를 읽고 처리 결과를 씁니다. |
| 자원 관리 | Standalone, YARN, Kubernetes | 응용 프로그램에 계산 자원을 배정합니다. 이번에는 Spark의 Standalone을 씁니다. |
| 처리 | Spark | ETL(추출·변환·적재), SQL, 지속적으로 들어오는 데이터 처리, 기계학습용 특징 데이터 준비를 수행합니다. |
| 일정과 활용 | Airflow 등 실행 일정 도구, 분석용 저장소, BI(업무 분석), ML(기계학습) | 작업 순서를 관리하거나 결과를 활용합니다. |
큰 표를 합치는 Join(조인), 집계, 데이터 정제, 반복 분석에 활용합니다. 짧은 응답 시간이 필요한 서비스나 OLTP(온라인 거래 처리) 데이터베이스를 대신하는 도구는 아닙니다.
아래는 강의 당시 소개된 사례입니다.
관리형 Spark 사례로 Amazon EMR, Google Cloud의 Managed Service for Apache Spark, Microsoft Fabric Spark, Databricks Runtime을 소개합니다.
Spark가 종료되면 영구 저장한 결과 파일도 사라질까요? 외부 저장소에 쓴 결과는 계산 엔진이 종료되어도 남을 수 있습니다. 결과를 저장한 위치를 확인하세요.
출처: 3장 「분산처리와 Spark 실행 원리」 슬라이드 9–17.
컨테이너가 켜져 있어도 계산은 아직 시작되지 않았을 수 있습니다. 자원을 준비하는 역할과 제출한 프로그램을 계산하는 역할은 서로 다릅니다.
역할을 두 쌍으로 나누면 다음과 같습니다. Master와 Worker는 쓸 수 있는 계산 자원을 준비합니다. 프로그램을 제출하면 Driver가 작업을 지휘하고, Executor가 나누어 받은 숫자를 계산합니다.
시설 담당자는 강의실을 배정하고 수업 담당자는 수업을 진행합니다. 이처럼 Master는 자원을 배정하고 Driver는 계산 작업을 조정합니다.
| 프로세스 | 실행 위치 | 역할과 수명 |
|---|---|---|
| Master | spark-master | Worker 등록과 자원 배정을 담당합니다. 클러스터가 켜져 있는 동안 유지됩니다. |
| Worker | 각 Worker 컨테이너 | 자원을 보고하고 Executor를 시작·감시합니다. Application 종료 후에도 유지됩니다. |
| Driver | spark-client | 사용자 코드와 실행 계획을 관리하고 Task를 보냅니다. 제출 후 시작해 프로그램 종료 시 끝납니다. |
| Executor | Worker 컨테이너 내부 | Application을 위해 시작되어 Task를 계산하고 중간 데이터를 관리합니다. Application 종료 시 정리됩니다. |
위 그림은 학습용 구조 모형입니다. 준비부터 계산까지 다음 순서로 진행됩니다.
spark-submit이 Driver를 시작합니다.--deploy-mode client: 배포 스크립트의 이 설정 때문에 Driver가 spark-client에서 실행됩니다.출처: 3장 「분산처리와 Spark 실행 원리」 슬라이드 18–22, 26, 28–29. 구조 보충: Apache Spark 4.1.3 공식 실행 구조.
데이터가 여러 곳에 나뉘어 있어도 열 이름으로 계산을 지정할 수 있습니다. DataFrame(데이터프레임)은 이름이 있는 열로 구성된 표 형태의 분산 데이터입니다.
성적표를 여러 조교에게 나누어 주어도 “점수 열의 합계”라는 요청은 같습니다. 점수 열은 표의 구조이고, 조교에게 나눈 묶음은 데이터 조각입니다.
id입니다.id는 long, 즉 64비트 정수형입니다.Python 변수 numbers는 이 분산 표를 다루는 객체를 가리킵니다. 모든 행을 Python 리스트로 가져오는 것은 아닙니다. Spark는 데이터 생성과 변환 계획을 관리하고, 실행이 필요해지면 Executor가 조각별로 처리하게 합니다.
읽기용 Python 코드입니다. first_app.py에서 이미 만든 spark를 사용하며, PowerShell에 직접 입력하지 않습니다.
numbers = spark.range(1, 101, 1, 4)1: 시작값을 포함합니다.101: 끝 경계는 포함하지 않으므로 마지막 값은 100입니다.1: 숫자가 증가하는 간격입니다.4: 입력 Partition 수입니다. Worker 수나 열 수가 아닙니다.| 행 설명 | id · long |
|---|---|
| 시작값 | 1 |
| 다음 값 | 2 |
| 중간 행 생략 | 3부터 99까지 |
| 마지막 값 | 100 |
표는 100행 × 1열이고 입력 Partition은 4개입니다. 위 표는 숫자 범위를 보여 주는 예시이며, DataFrame의 출력 순서는 명시적으로 정렬해야 보장됩니다.
합계를 구하는 코드는 다음 한 줄입니다.
total = numbers.selectExpr("sum(id) AS total").first()["total"]아래는 같은 계산을 설명용 변수로 나눈 코드입니다. 실습 파일은 그대로 실행합니다.
summary = numbers.selectExpr("sum(id) AS total")
row = summary.first()
total = row["total"]
assert total == 5050, f"Unexpected result: {total}"selectExpr: SQL(표의 데이터를 조회·처리하는 언어) 식을 문자열로 받아 새 DataFrame을 정의합니다. 여기서는 전체 id 값을 더하는 계획입니다.sum(id) AS total: sum은 합계, AS total은 결과 열의 이름입니다. 기존 numbers의 id 열을 덮어쓰지 않습니다.summary.first(): 합계 표의 첫 행을 요구합니다. 이때 실제 계산이 필요해집니다. 입력의 첫 숫자 1을 가져오는 호출이 아닙니다.row["total"]: 가져온 행에서 열 이름으로 값을 꺼냅니다. 이미 Driver가 받은 행을 읽으므로 별도의 분산 계산을 요청하지 않습니다.assert: 참이어야 할 조건을 검사합니다. 합계가 5050과 다르면 오류를 내고 정상 확인 출력을 진행하지 않습니다.| 변수 | 자료형 | 뜻과 예상 내용 |
|---|---|---|
numbers | DataFrame | id 열에 1부터 100까지 있는 입력 표 |
summary | DataFrame | total 열의 한 행짜리 합계 표를 정의한 계획. 계산 결과는 5050 |
row | Row | 계산 후 받은 한 행 Row(total=5050) |
total | Python 정수 | 행 안에서 꺼낸 숫자 5050 |
total = row["total"]에서 왼쪽 total은 Python 변수 이름이고, 따옴표 안의 "total"은 AS total로 붙인 열 이름입니다. 이름은 같아도 역할은 다릅니다.
아래는 코드 이해를 위한 선택적 확인 예시입니다. show()도 실행을 요청하므로, 실습의 Job·Task 수를 관찰할 때는 파일에 코드를 추가하지 마세요.
numbers.printSchema()   # 열 이름과 자료형 확인
summary.explain()       # 합계를 구할 실행 계획 확인
summary.show()          # 결과를 계산해 표 형태로 출력
이 합계 예제에서 printSchema()와 explain()은 구조와 계획을 보여 주고, show()는 실제 결과를 계산해 출력합니다.
예상 결과의 핵심: 입력 스키마의 열은 id: long이고, 합계 표는 total 열 하나에 5050이 들어 있는 한 행입니다.
다음 절에서는 계획을 만드는 Transformation과 결과를 요구하는 Action을 구분합니다.
출처: 3장 「분산처리와 Spark 실행 원리」 슬라이드 23, 32–34 · 배포 코드. 표와 단계별 변수는 학습용 보충입니다. API 참고: DataFrame·스키마 · range · first.
Spark는 변환 계획을 모아 두었다가 결과가 필요할 때 계산합니다. 여러 처리 단계를 함께 보고 실행 방법을 정하기 위해서입니다.
주문서에 요리를 적는 것은 계획이고, 조리는 실행입니다. 변환은 계획을 만들고 실행 요청은 결과를 요구합니다. 주문서 줄 수가 실제 작업 수와 같지는 않습니다.
selectExpr("sum(id) AS total")은 “id 열의 합계를 구해 total이라는 열에 담자”는 계획을 만듭니다.first()는 합계 표의 첫 행을 가져오라고 요청합니다.| 단위 | 의미 | 합계 예제 |
|---|---|---|
| Partition | 데이터를 나눈 조각 | 1부터 100을 네 조각으로 나눕니다. |
| Task | Executor가 한 Partition을 처리하는 실행 단위 | 입력 조각별 합계를 계산합니다. |
| Job | Action의 결과를 구하려고 시작하는 계산 단위 | first()로 합계 결과를 요구합니다. |
| Stage | 데이터 재배치 경계를 기준으로 나뉜 Task 묶음 | 부분 합계 단계와 최종 합계 단계가 있습니다. |
Application → Job → Stage → Task 순으로 포함됩니다. Shuffle(셔플)은 다음 계산에 맞춰 데이터를 재배치하는 과정이며 Stage를 나누는 경계가 됩니다.
화면의 Job 수가 코드의 Action 호출 수와 항상 같지는 않습니다.
출처: 3장 「분산처리와 Spark 실행 원리」 슬라이드 23–27, 45–48.
단어별 등장 횟수를 구하려면 문장을 단어 행으로 나누고 같은 단어를 모아 셉니다. 문장 읽기 → 단어 분리 → 집계 → 저장 순서로 표가 바뀝니다.
문장 카드를 단어마다 잘라 같은 단어끼리 쌓고, 더 두꺼운 묶음부터 놓는 과정입니다. 실제 Spark에서는 문자열을 나누고, 행을 늘리고, 그룹별로 집계한 뒤 정렬합니다.
아래 코드는 HDFS(여러 컴퓨터에 파일을 나누어 저장하는 파일 시스템)의 입력을 가정합니다. 이 장의 환경에는 HDFS가 없으므로 여기서는 연산의 흐름을 읽습니다. 직접 실행하려면 이 절 끝의 문장 파일 실습을 사용하세요.
from pyspark.sql import SparkSession, functions as F
spark = SparkSession.builder.appName("df-wordcount").getOrCreate()
lines = spark.read.text("hdfs:///user/$USER/week10/input")
words = (lines
    .select(F.explode(F.split(F.col("value"), r"\s+")).alias("word"))
    .where(F.col("word") != ""))
result = words.groupBy("word").count().orderBy(F.desc("count"))
result.write.mode("overwrite").parquet("hdfs:///user/$USER/week10/df-output")
spark.stop()
functions as F: Spark 함수들을 F라는 짧은 이름으로 쓰겠다는 뜻입니다.lines → words → result: 입력 표, 단어 표, 집계 표에 붙인 Python 변수 이름입니다.lines = spark.read.text("hdfs:///user/$USER/week10/input")기본 텍스트 읽기는 줄마다 한 행을 만들고, 내용은 value라는 문자열 열에 넣습니다. 아래부터는 학습용으로 가정한 세 줄을 사용합니다. 직접 실행해 얻은 출력은 아닙니다.
| 입력 줄 | value · 문자열 |
|---|---|
| 첫째 줄 | spark spark |
| 둘째 줄 | data spark |
| 셋째 줄 | "" · 빈 문자열 |
words = (lines
    .select(F.explode(F.split(F.col("value"), r"\s+")).alias("word"))
    .where(F.col("word") != ""))
괄호가 많을 때는 가장 안쪽 함수부터 읽습니다. 다음 함수들이 만든 열 표현식을 select에 전달하면, 그 열을 가진 새 DataFrame을 정의합니다.
F.col("value"): 입력의 value 열을 가리키는 표현식입니다. 지금 당장 문자열 한 개를 꺼내는 동작은 아닙니다.F.split(..., r"\s+"): 공백을 기준으로 문자열을 배열로 나눕니다. \s+는 하나 이상의 공백 문자를 뜻하는 정규식(문자열을 찾거나 나누는 규칙)이고, r은 Python에서 역슬래시를 그대로 쓰게 합니다.F.explode(...): 배열의 원소 하나를 행 하나로 펼칩니다. 두 단어가 들어 있던 한 행이 두 행이 됩니다..alias("word"): 펼친 결과 열에 word라는 이름을 붙입니다..where(F.col("word") != ""): 단어가 빈 문자열이 아닌 행만 남깁니다. 비교 연산자 !=는 “같지 않다”라는 뜻입니다.| 단계 | 값 또는 행 | 구조 변화 |
|---|---|---|
| 입력 | "spark spark" | 문자열 하나, 한 행 |
| split | ["spark", "spark"] | 문자열 배열, 아직 한 행 |
| explode와 alias | word="spark"인 행 2개 | 배열의 원소가 각각 별도 행 |
세 줄 전체에 적용하면 빈 문자열 제거 후 spark, spark, data, spark의 4개 행이 남습니다. 여기까지는 어떤 단어를 셀지 정하는 변환 계획입니다.
result = words.groupBy("word").count().orderBy(F.desc("count"))groupBy("word"): 같은 word 값끼리 묶어서 집계하도록 지정합니다. 중간 결과는 그룹 집계를 준비하는 GroupedData 객체입니다.count(): 각 그룹의 행 수를 count 열에 담는 DataFrame을 정의합니다. 단어의 글자 수를 세는 것이 아닙니다.orderBy(F.desc("count")): 등장 횟수가 큰 행부터 정렬합니다. 횟수가 같은 단어끼리의 순서는 이 코드로 정하지 않습니다.| word · 문자열 | count · 정수 |
|---|---|
| spark | 3 |
| data | 1 |
words.groupBy("word").count(): 단어별 개수의 DataFrame을 만드는 변환입니다.words.count(): 전체 행 수를 계산해 Python 정수를 돌려주는 Action입니다. 위 가정에서는 4입니다.result.write.mode("overwrite").parquet("hdfs:///user/$USER/week10/df-output")
spark.stop()result.write: 결과를 저장하는 도구를 얻습니다.mode("overwrite"): 같은 출력 위치가 이미 있으면 기존 결과를 교체하는 저장 모드입니다.parquet(...): 열을 기준으로 데이터를 저장하는 Parquet(파케이) 형식으로 결과를 씁니다. 이 저장 요청이 계산을 요구하는 Action입니다. 출력 경로에는 여러 데이터 파일이 생길 수 있습니다.spark.stop(): 저장을 마친 뒤 SparkSession을 종료합니다.위 단계는 단어 집계와 정렬의 학습용 모형입니다. 실제 Job·Stage 수는 실행 계획에 따라 달라지며, 코드 한 줄이 반드시 Stage 하나에 대응하지는 않습니다.
출처: 3장 「분산처리와 Spark 실행 원리」 슬라이드 23–25. 전체 코드는 슬라이드 24, 입력과 중간 표는 학습용 보충입니다. API 참고: explode · 그룹별 count · 전체 count.
합성 문장으로 단어를 세는 보충 실습에는 입력 텍스트, 전체 Python 코드, 예상 CSV가 있습니다. HDFS 없이 local[2]에서 입력·중간 표·Parquet 저장과 재읽기를 확인합니다. 클러스터 Worker 비교는 별도의 분산 실습에서 진행합니다.
환경 설정·제출 스크립트·계산 코드를 연결해 실행 흐름을 확인합니다. 각 프로세스가 시작되고, 합계를 계산·검증한 뒤 종료되는 순서입니다.
배치도는 사용할 장비를 준비하고, 지시서는 실험을 시작하며, 실험식은 계산을 정합니다. 설정 파일과 제출 스크립트, Python 코드도 역할이 나뉩니다.
x-spark와 &spark: 이미지와 공통 옵션에 이름을 붙입니다. 각 서비스의 <<: *spark가 같은 설정을 가져옵니다../apps:/opt/spark/apps:ro: PC의 apps 폴더를 Client 컨테이너 안에 연결합니다. ro는 읽기 전용이므로 컨테이너에서 제공 코드를 덮어쓰지 않습니다.127.0.0.1:4040:4040: 내 PC의 4040 포트에서 Client 컨테이너의 4040 포트로 연결합니다. Master의 8080은 자원 상태, Driver의 4040은 프로그램 실행 상태를 보는 주소입니다.depends_on과 healthcheck: Master의 웹 응답이 확인된 뒤 다른 서비스를 시작합니다. Worker가 실제 등록되었는지는 실행 화면에서 따로 확인합니다.docker compose up으로 컨테이너를 시작한 상태와 Application을 제출한 상태를 구분하세요. 계산 제출은 다음 명령으로 별도 수행합니다.
실행 흐름을 읽는 예시입니다. 실제 실행은 다음 환경 점검을 마친 뒤 진행합니다.
docker compose exec spark-client bash /opt/spark/apps/run.sh --wait-seconds 300docker compose exec spark-client: 이미 실행 중인 Client 컨테이너 안에서 명령을 실행합니다.bash /opt/spark/apps/run.sh: 컨테이너 안의 Bash 셸로 제출 스크립트를 읽습니다. 호스트의 apps 폴더가 이 경로에 연결되어 있습니다.--wait-seconds 300: 계산이 끝난 후 UI를 300초 유지하라는 Python 프로그램 인자입니다.앞의 run.sh 전체 코드는 다음과 같이 동작합니다. spark-submit은 계산 프로그램을 Spark에 제출하는 명령입니다. 계산 자원의 위치와 사용량을 옵션으로 전달합니다.
set -euo pipefail: 명령 실패나 미정의 변수 같은 오류를 놓치지 않도록 셸 동작을 설정합니다.exec와 spark-submit: 셸 프로세스를 Spark 제출 프로그램으로 교체합니다. 이 예제는 client 모드이므로 Driver가 Client 컨테이너에서 실행됩니다.\: 여러 줄에 쓴 내용을 하나의 Bash 명령으로 이어 줍니다."$@": 전달받은 인자를 유지합니다. 앞의 --wait-seconds 300이 first_app.py까지 도착합니다.| 옵션 | 대상과 뜻 |
|---|---|
--master spark://spark-master:7077 | Driver가 연결할 내부 Master 주소 |
--deploy-mode client | 프로그램을 제출한 위치에서 Driver 실행 |
--driver-memory 512m | Driver의 JVM(자바 실행 환경) 메모리 |
--executor-memory 512m | Executor 하나의 JVM 메모리 |
--executor-cores 1 | Executor 하나가 사용할 코어 수 |
--total-executor-cores 2 | 이 Application 전체가 사용할 Executor 코어의 상한 |
spark.dynamicAllocation.enabled=false: 실행 중 동적으로 Executor 수를 조정하는 기능을 끕니다.spark.driver.host=spark-client: Executor에 알릴 Driver 주소입니다.spark.driver.bindAddress=0.0.0.0: 컨테이너 안의 모든 네트워크 인터페이스에서 Driver 연결을 받습니다.spark.driver.port=39000: Driver의 내부 통신 포트입니다.spark.blockManager.port=39001: 데이터 블록의 저장과 전송을 관리하는 BlockManager의 내부 통신 포트입니다.내부 통신 주소와 브라우저로 보는 Driver UI의 localhost:4040는 용도가 다릅니다.
first_app.py 전체 코드는 인자 읽기 → Spark 연결 → 합계 계산 → 정답 확인 → 화면 관찰 → 종료 순서입니다. 앞에서 배운 표 연산이 이 과정의 계산 부분에 들어갑니다.
argparse: 명령 뒤에 준 인자를 읽는 Python 도구입니다. type=int는 정수로 읽고, default=120은 생략했을 때의 값입니다.parse_args(): 전달받은 300을 args.wait_seconds에 저장합니다. 인자 이름의 하이픈은 속성 이름에서 밑줄이 됩니다.SparkSession.builder: 세션 설정을 준비합니다. appName은 UI에 보일 이름이고, getOrCreate()는 기존 세션을 사용하거나 새 세션을 만듭니다.spark.sparkContext: 현재 연결과 Application 정보를 확인합니다. 실제 계산을 조정하는 SparkContext는 Driver 안에서 동작합니다.setLogLevel("WARN"): 이후 로그 출력을 경고 이상 중심으로 줄입니다. 앞서 나온 시작 로그까지 없애지는 않습니다.MASTER와 APP_ID: 연결 주소와 실행 식별자를 출력합니다. 첫 assert는 의도한 분산 Master에 연결했는지 검사합니다.numbers와 total: 앞서 본 표 → 합계 표 → Row → 정수의 흐름입니다. first()에서 결과 계산을 요구합니다.SUM_1_TO_100와 두 번째 assert: 숫자를 출력하고, 손계산한 정답 5050과 비교합니다. 통과한 뒤에야 CHECK=PASS가 출력됩니다.flush=True: 관찰할 메시지가 출력 버퍼에 머물지 않도록 즉시 내보냅니다.max(0, args.wait_seconds): 음수 대기 시간을 0으로 보정합니다.time.sleep(...): 합계 계산이 끝난 후 Python 프로그램을 잠시 유지합니다. 이 시간에 UI를 봅니다.finally: spark.stop(): try 블록의 성공·실패와 관계없이 Spark 종료를 시도합니다. Session과 Context를 종료하고 Executor를 정리합니다.APP_STOPPED: 정상 경로에서 종료 정리를 마친 뒤 출력합니다. 앞서 예외가 발생하면 finally가 실행되어도 이 출력에 도달하지 않을 수 있으므로 오류 로그도 확인합니다.프로그램이 끝나도 Master와 Worker 컨테이너는 다음 제출을 기다릴 수 있습니다. 뒤의 실습에서 Application 종료와 클러스터 종료를 따로 관찰합니다.
run_performance.sh 전체 코드는 처음 합계 실습의 제출 스크립트와 같은 구조입니다. 달라지는 것은 전체 코어 상한을 고정된 숫자 대신 환경변수로 받는 부분입니다. C의 성능 비교 명령에서 이 값을 전달합니다.
TOTAL_EXECUTOR_CORES: PowerShell 명령의 -e TOTAL_EXECUTOR_CORES=4가 이 실행 프로세스에 환경변수 4를 전달합니다. 스크립트는 그 값을 --total-executor-cores에 넣습니다. 생략하면 1입니다.--executor-cores 1: Executor 하나가 사용할 코어를 1개로 고정합니다. Worker 하나도 1 Core이므로 전체 코어 상한을 늘리면 여러 Worker에 Executor를 배정할 수 있습니다.spark.dynamicAllocation.enabled=false: 이번 비교에서는 동적 자원 할당을 끄고 제출한 코어 조건을 유지합니다."$@": 명령 뒤의 --end, --partitions, --repetitions, --wait-seconds 인자를 Python 파일로 그대로 전달합니다. 코어 수는 제출 옵션이고 입력 범위·반복 수는 Python 프로그램의 인자입니다.앞의 performance_app.py 전체 코드 중 시간 측정 부분을 발췌한 코드입니다. SparkSession 생성과 인자 검사는 포함하지 않습니다.
args: 명령행 인자를 읽어 보관한 값입니다.spark: 앞에서 생성한 SparkSession입니다.numbers = spark.range(1, args.end, 1, args.partitions)
expected = (args.end - 1) * args.end // 2
elapsed_values = []
for run_number in range(1, args.repetitions + 1):
started = time.perf_counter()
total = numbers.selectExpr("SUM(id) AS total").first()["total"]
elapsed = time.perf_counter() - started
assert total == expected, f"Unexpected result: {total}"
elapsed_values.append(elapsed)
print(f"RUN_{run_number}_SECONDS={elapsed:.3f}", flush=True)
median_seconds = statistics.median(elapsed_values)
print(f"SUM_RESULT={total}", flush=True)
print(f"MEDIAN_SECONDS={median_seconds:.3f}", flush=True)
print("CHECK=PASS", flush=True)
print(f"UI observation: {max(0, args.wait_seconds)} seconds", flush=True)
time.sleep(max(0, args.wait_seconds))spark.range는 id 열을 가진 분산 DataFrame을 만듭니다. 기본값에서는 1부터 10억까지의 행을 128개 Partition으로 다룰 계획입니다. Python 리스트나 10억 행 파일을 먼저 만들지 않습니다.expected는 Python 정수입니다. 1부터 end - 1까지의 등차수열 합 공식을 계산하며 Spark 실행과 독립적으로 정답을 확인하는 기준입니다.range(1, args.repetitions + 1)은 기본값에서 1, 2, 3 순으로 반복합니다. started와 elapsed는 시간을 나타내는 Python 실수이며 elapsed의 단위는 초입니다. 반복마다 집계 표현식을 새로 만들고 결과를 요청합니다.selectExpr(...)는 total 열이 있는 집계 DataFrame을 정의합니다. first()가 계산을 요청해 첫 Row를 Driver로 가져오고, ["total"]이 그 행에서 Python 정수 합계를 꺼냅니다. 기본 예상값은 500000000500000000입니다.assert가 예상 합계와 일치하는지 검사한 다음 시간을 elapsed_values라는 Python 리스트에 저장합니다. 정답이 다르면 검증 오류로 중단하므로 성공한 측정처럼 기록하면 안 됩니다.statistics.median은 세 시간 중 가운데 값을 돌려줍니다. RUN_1_SECONDS부터 RUN_3_SECONDS, 합계, 중앙값, PASS를 출력한 뒤 UI 관찰 시간만큼 기다립니다. 관찰 대기는 위 타이머 밖이므로 중앙값에 더해지지 않습니다.정상 실행에서는 관찰 대기 후 finally 블록에서 spark.stop()을 호출해 세션을 종료합니다. 오류가 나도 종료를 시도하며, 정상 경로에서만 APP_STOPPED를 출력하고 프로그램이 끝납니다.
하나의 Application 안에서 같은 입력 정의로 세 번 집계하지만 cache()나 persist()는 호출하지 않습니다.
시간이 너무 짧거나 길면 --end를 조정하되 모든 비교 조건에서 같은 값을 쓰세요. 정답은 (end - 1) × end ÷ 2로 바뀝니다. 가장 빠른 한 번만 고르지 말고 세 번과 중앙값을 기록합니다.
전체 코어 상한이 2인데 Worker 한 개만 살아 있고 코어가 1개라면? 제공 가능한 1개 코어 안에서 계산합니다. 제출 옵션의 상한이 실제 자원을 새로 만들지는 않습니다.
출처: 3장 「분산처리와 Spark 실행 원리」 슬라이드 28–37 · 「Spark Worker 확장과 성능 측정」 1–2쪽 · 실행 관찰·성능 측정 코드.
환경을 점검하고 작은 합계 계산을 실행한 뒤, 화면에서 데이터와 자원의 관계를 확인합니다.
실행 관찰 자료 ZIP 받기 · 압축을 푼 BigData 폴더에서 시작합니다.
Docker와 실습 파일을 확인하고 두 Worker를 시작한 뒤 통신을 검사합니다. 점검을 마치면 다음 절에서 1부터 100까지의 합계 프로그램을 제출합니다.
2장 실습 파일을 사용합니다. compose.yaml로 계산 자원을 준비하고, 다음 절에서 run.sh를 통해 앞에서 읽은 first_app.py를 제출합니다.
실험 전에 전원과 장비 연결을 따로 점검하듯, 이미지와 네트워크 연결도 각각 검사합니다.
Docker Desktop에서 Engine running을 기다린 뒤 실행하세요. 실행 위치: BigData 폴더의 PowerShell.
docker info
cd ".\실습자료\2장_실습자료"
Get-ChildItem
docker compose config --quietdocker info에 Client와 Server가 모두 표시.compose.yaml과 apps 확인.docker compose config --quiet가 오류 없이 종료.이후 실행 위치: 2장 실습 폴더의 PowerShell.
docker image ls spark:4.1.3-scala2.13-java21-python3-ubuntu이미지가 없을 때만 내려받습니다.
docker pull spark:4.1.3-scala2.13-java21-python3-ubuntu일회용 Client 컨테이너의 로컬 모드 · 코어 1개로 검사합니다. 분산 계산은 다음 단계에서 확인합니다.
docker compose run --rm --no-deps --entrypoint /opt/spark/bin/spark-submit spark-client --master "local[1]" /opt/spark/apps/check_pyspark.pyPYSPARK_VERSION=4.1.3PYSPARK_IMAGE_CHECK=PASS실행 위치: 2장 실습 폴더의 PowerShell. 이전 Application이 실행 중이라면 먼저 종료를 기다립니다.
현재 compose.yaml은 Master·Worker 1·Worker 2·Client 네 서비스를 정의합니다. --remove-orphans는 같은 Compose 프로젝트에서 현재 설정에 없는 서비스의 컨테이너를 제거합니다. 실행 전에 같은 프로젝트에서 유지해야 할 컨테이너가 있는지 확인하세요. Docker Compose up 공식 문서에서 옵션을 확인할 수 있습니다.
docker compose up -d --remove-orphans spark-master spark-worker-1 spark-worker-2 spark-client
docker compose ps -a
현재 설정의 네 컨테이너가 실행 중인지 확인합니다.
spark-master, spark-worker-1, spark-worker-2, spark-client 모두 Up.| UI 항목 | 강의 예시 값 | 해석 |
|---|---|---|
| ALIVE Workers | 2 | 자원을 제공할 Worker 수 |
| Cores Total / Used | 2 / 0 | 준비된 코어는 2개, 현재 사용은 0개 |
| Running Applications | 0 | 아직 계산을 제출하지 않은 상태 |
이전에 중지한 Worker의 DEAD 행이 남아 있어도 현재 ALIVE 수가 기준입니다.
docker compose exec spark-client python3 /opt/spark/apps/check_network.py7077과 Worker 내부 8081 포트의 TCP 연결 통과.NETWORK_CHECK=PASS.docker compose logs spark-master spark-worker-1 spark-worker-2로 진단.로그 명령은 보충 진단용입니다. Master의 healthy는 웹 응답 확인이므로 Worker 등록도 따로 확인하세요.
컨테이너가 네 개 Up인데 Used Cores가 0이면 고장일까요? Application 제출 전이라면 정상입니다. 준비된 자원과 사용 중인 자원을 구분하세요.
출처: Spark 분산 실행 실습 절차서 1–3쪽, 단계 1–8 · 3장 「분산처리와 Spark 실행 원리」 슬라이드 39–41 · 이미지 검사 원본 · 네트워크 검사 원본.
다음 절로 이동할 조건: ALIVE Worker 2개, Used Cores 0, NETWORK_CHECK=PASS를 확인한 뒤, Master UI를 열어 둔 채 Application을 제출합니다.
정답 5050은 계산의 정확성을 보여 줍니다. 그 계산에 어떤 자원이 참여했는지는 Master UI와 Driver UI를 함께 봐야 알 수 있습니다.
배정표는 누가 참여했는지, 작업 기록은 무슨 일을 끝냈는지 보여 줍니다. Master UI는 자원 배정, Driver UI는 계산 기록을 확인하는 화면입니다.
실행 위치: 2장 실습 폴더의 PowerShell. 앞 절의 두 Worker 준비가 끝난 상태입니다. 계산 후 300초 동안 프로그램을 유지하도록 실행합니다.
docker compose exec spark-client bash /opt/spark/apps/run.sh --wait-seconds 300예상 출력의 주요 부분입니다. APP_ID는 실행마다 달라지고 시작 로그가 추가됩니다.
MASTER=spark://spark-master:7077
APP_ID=app-...
SUM_1_TO_100=5050
CHECK=PASS
UI observation: 300 seconds위 메시지가 보이면 아래 화면을 여세요. APP_STOPPED가 나오면 Application과 Driver UI가 종료됩니다. PowerShell이 돌아오지 않아도 관찰 대기 중이라면 정상입니다.
| 화면 | 확인할 항목 | 읽는 방법 |
|---|---|---|
| Master · 8080 | Workers 2 Alive, Cores 2 Total / 2 Used, Week02-First-App RUNNING | 클러스터 자원과 실행 중인 Application 확인 |
| Driver · 4040 / Jobs | 관찰 예시에서는 Job 0의 Task 4개, Job 1의 완료 Task 1개와 Skipped 4개 | 작업의 완료 여부를 확인하고, 생략된 항목을 완료 횟수에 더하지 않기 |
| Driver / Stages | 관찰 예시에서는 Stage 0의 4개, Stage 2의 1개 완료, Stage 1은 Skipped | 입력 계산과 최종 집계가 나뉜다는 점 확인 |
| Driver / Executors | Driver 행과 Executor 2개, Executor마다 1 Core, 완료 Task 합계 5개 | Driver 행을 Worker 쪽 Executor 개수에서 제외 |
| Worker 1 · 8081 / Worker 2 · 8082 | 각 Worker의 자원과 Executor | Worker가 제공한 자원과 그 안의 실행 프로세스 구분 |
Week02-First-App을 찾습니다. 터미널의 APP_ID와 화면의 실행 ID를 비교합니다.대기 중에는 합계 계산이 끝났어도 Application이 살아 있어 자원 할당이 유지됩니다.
| UI 항목 | 강의 예시 값 | 해석 |
|---|---|---|
| ALIVE Workers | 2 | 두 Worker가 등록됨 |
| Cores Total / Used | 2 / 2 | Application에 두 코어가 배정됨 |
| Application | RUNNING | 계산 완료 후 관찰 대기 중에도 표시될 수 있음 |
Driver UI의 Jobs 탭을 엽니다. Job은 실제 계산 요청으로 만들어진 실행 단위입니다. 관찰 예시의 Job 0은 Task 4개를, Job 1은 Task 1개를 완료했고 이전 부분의 Task 4개는 Skipped로 표시됩니다.
| UI 항목 | 강의 예시 값 | 해석 |
|---|---|---|
| 입력 계산 | 완료 Task 4개 | 네 Partition을 처리 |
| 최종 집계 | 완료 Task 1개 | 부분 합계를 하나로 합침 |
| Skipped | 완료 수에서 제외 | 재사용 등으로 실행하지 않은 작업 표시 |
Stages 탭에서는 Job 안의 계산 단계를 봅니다. 네 입력 Partition은 입력 Stage의 Task 네 개로 처리됩니다. 부분 합계를 모아 전체 합계 하나를 만드는 마지막 Stage에는 Task 한 개가 필요합니다.
| UI 항목 | 강의 예시 값 | 해석 |
|---|---|---|
| 입력 Stage | Task 4개 | 입력 Partition마다 처리 |
| 집계 Stage | Task 1개 | 부분 결과를 모아 합산 |
| Stage 번호 | 실행별로 확인 | 번호 자체보다 처리 내용과 완료 상태를 읽기 |
화면을 입력 Partition 4개 → 부분 계산 Task 4개 → 최종 집계 Task 1개 → 5050으로 연결해서 설명해 보세요.
Executors 탭의 Driver 행은 제외하고 Worker 쪽 Executor를 셉니다.
각 Executor가 1 Core를 쓰고 두 Executor의 완료 Task 합계가 5이면, 앞의 4개 입력 계산과 1개 최종 집계가 두 계산 프로세스에 배정된 것입니다.
| UI 항목 | 강의 예시 값 | 해석 |
|---|---|---|
| Driver | 1행 | 계산을 지휘하는 프로세스이므로 Executor 수에서 제외 |
| 계산용 Executor | 2개 · 각 1 Core | 동시에 최대 두 Task 실행 |
| 완료 Task 합계 | 5개 | Executor별 배분은 실행마다 다를 수 있음 |
출처: Spark 분산 실행 실습 절차서 3쪽, 단계 9–10 · 3장 「분산처리와 Spark 실행 원리」 슬라이드 42–48의 실행 화면.
다음 절로 이동할 조건: 5050 / PASS, Executor 2개, 완료 Task 합계 5개를 기록한 뒤 APP_STOPPED까지 기다립니다. 그다음 Worker 수만 바꿉니다.
입력 데이터와 분할은 그대로 두고 Worker만 줄입니다. 전체 작업 수와 동시에 실행할 작업 수가 어떻게 다른지 확인합니다.
조교 한 명이 자리를 비워도 남은 조교가 같은 시험지 묶음을 차례로 채점할 수 있습니다. 실습도 계산이 끝난 뒤 Worker를 줄여 비교하므로, 계산 도중 장애 복구 실험은 아닙니다.
실행 위치: 2장 실습 폴더의 PowerShell. 먼저 APP_STOPPED까지 기다린 다음 실행합니다.
docker compose stop spark-worker-2
docker compose ps -a
Master UI에서 ALIVE Worker가 1개로 줄었는지 확인합니다. 두 개가 남았다면 docker compose ps -a에서 spark-worker-2가 Exited인지 확인한 뒤 Master UI를 새로 고칩니다.
입력이나 Partition 수를 바꾸지 않고 같은 명령을 실행합니다. UI observation: 300 seconds가 나오면 Master와 Driver 화면을 새로 고칩니다.
docker compose exec spark-client bash /opt/spark/apps/run.sh --wait-seconds 300spark-worker-2는 Exited.SUM_1_TO_100=5050, CHECK=PASS.| UI 항목 | 강의 예시 값 | 해석 |
|---|---|---|
| ALIVE Workers | 1 | 중지한 Worker의 DEAD 기록과 구분 |
| Cores Total / Used | 1 / 1 | 한 코어로 같은 계산을 수행 |
| Application | RUNNING | 관찰 대기가 끝나면 종료 |
| UI 항목 | 강의 예시 값 | 해석 |
|---|---|---|
| 계산용 Executor | 1개 | Driver 행은 제외 |
| 완료 Task 합계 | 5개 | 입력 4개와 최종 집계 1개를 차례로 처리 |
| 합계 | 5050 | Worker 수가 줄어도 입력과 계산 결과는 같음 |
| 항목 | Worker 2개 | Worker 1개 |
|---|---|---|
| Worker 쪽 Executor / 사용 코어 | 2개 / 2개 | 1개 / 1개 |
| 입력 Partition / 입력 Task | 4개 / 4개 | 4개 / 4개 |
| 최종 집계 Task / 완료 Task 합계 | 1개 / 5개 | 1개 / 5개 |
| 동시 Task 상한 | 2개 | 1개 |
| 합계와 검증 | 5050 / PASS | 5050 / PASS |
Worker를 줄였는데 왜 입력 Task와 합계는 같을까요? 입력 데이터와 분할 수를 바꾸지 않았기 때문입니다. 바뀐 것은 동시에 처리할 자원입니다.
100개 숫자는 너무 작으므로 이 실습의 실행 시간 차이만으로 성능을 결론 내리지 않습니다.
두 번째 APP_STOPPED를 확인한 뒤 실행합니다.
docker compose start spark-worker-2
docker compose ps -a
Master UI에서 ALIVE Worker가 다시 2개인지 확인한 다음 환경을 정리합니다.
docker compose down
docker compose ps -a
서비스 목록이 비었는지 확인하세요. 이 프로젝트의 실습 파일과 Spark 이미지는 유지되며 다음 성능 비교에서도 이미지를 재사용합니다.
출처: Spark 분산 실행 실습 절차서 3–5쪽, 단계 11–14와 결과표 · 3장 「분산처리와 Spark 실행 원리」 슬라이드 49–54.
다음 실험으로 이동할 조건: 두 Worker와 한 Worker의 정답·Task 수·동시 실행 수를 비교하고, docker compose down 뒤 서비스 목록이 비었는지 확인합니다. 다음 실험에서는 3장 파일로 입력을 늘려 성능을 비교합니다.
구조를 확인한 뒤 같은 계산의 자원 조건과 시간을 비교합니다.
자원·성능 비교 자료 ZIP 받기 · 앞에서 받은 자료가 있다면 그대로 사용합니다.
작은 합계에서는 동시에 처리하는 구조를 확인했습니다. 이제 입력을 1부터 10억까지로 늘려 같은 계산을 Worker 1·2·4·8개에서 실행합니다. 입력과 반복 수를 고정하고 자원 조건만 바꾸어 시간을 비교합니다.
인원 효과를 비교하려면 맡기는 일의 분량도 같아야 합니다. 실제 실험에서는 입력 범위, Partition 수, 반복 수를 고정합니다.
Worker가 많다는 사실만으로 프로그램이 모든 자원을 쓰지는 않습니다. 아래 항목을 따로 기록해야 시간이 달라진 이유를 설명할 수 있습니다.
| 기준 | 확인 위치 | 뜻 |
|---|---|---|
| 준비된 자원 | Master의 ALIVE Workers·Total Cores | 클러스터가 제공할 수 있는 Worker와 코어 수입니다. |
| 프로그램에 배정된 자원 | Master의 Used Cores, Driver의 Executors | 이번 Application에 배정된 코어와 계산 프로세스입니다. 순간 CPU 사용률을 뜻하지 않습니다. |
| 실행 중 실제 사용 | 진행 중 Task, 컨테이너의 CPU·메모리 통계 | 관찰한 순간 계산이 진행 중인지, 실제 CPU·메모리를 얼마나 쓰는지 확인합니다. |
실행 위치: 앞 절을 마친 2장 실습 폴더의 PowerShell. 앞에서 실행한 클러스터를 종료한 뒤 형제 폴더로 이동합니다.
cd "..\3장_실습자료"
Get-ChildItem
Get-ChildItem .\apps
docker info
docker compose config --quiet
이 절부터 시작한다면 BigData 폴더에서 cd ".\실습자료\3장_실습자료"로 이동하세요. 이후 성능 비교의 Compose 명령은 3장 실습 폴더에서 실행합니다.
bigdata-week03-scale입니다. Master, 복제 가능한 spark-worker, Client를 정의합니다.TOTAL_EXECUTOR_CORES 환경변수를 전체 Executor 코어 상한으로 전달합니다. 지정하지 않으면 1입니다.| 조건 | 값 | 읽는 방법 |
|---|---|---|
| 입력 범위 | --end 1000000001 | 1부터 1,000,000,000까지. 끝값은 제외합니다. |
| 입력 Partition | --partitions 128 | 입력을 128개로 나눕니다. |
| 반복 수 | --repetitions 3 | 하나의 Application 안에서 합계 Action을 세 번 실행합니다. |
| Executor | 각각 1 Core / 512m | 이번 설정에서는 할당된 코어 수와 Executor 수가 대응합니다. |
| Worker | 각각 1 Core / 1g | Spark에 보고하는 자원 설정입니다. 컨테이너 자체의 엄격한 메모리 상한을 뜻하지 않습니다. |
| 대표 시간 | MEDIAN_SECONDS | 세 번 측정값을 정렬했을 때 가운데 값입니다. |
spark.range가 숫자를 만듭니다. 10억 행 파일을 미리 만들지 않습니다.time.perf_counter()로 집계 표현식 selectExpr(...).first()["total"] 직전부터 결과를 받은 직후까지 측정합니다. 집계 계획 생성과 실제 계산·결과 반환이 이 구간에 포함됩니다.spark-worker-1·spark-worker-2 대신 spark-worker 서비스 하나를 복제합니다.HOSTNAME 환경변수를 사용합니다.$$: 변수를 컨테이너 안의 셸에서 해석하도록 전달합니다.반복 시간이 9초, 4초, 5초라면 중앙값은? 5초입니다. 위 시간은 중앙값을 설명하는 가상 숫자입니다.
출처: Spark Worker 확장과 성능 측정 1–2쪽, 6쪽 · 3장 실습 파일. 측정 범위: performance_app.py 기준. 변수 표기 보충: Docker 공식 문서의 $$ 처리.
다음 절로 이동할 조건: 3장 폴더에서 설정 검사를 통과하고 코어 조건과 입력·반복 조건을 구분한 뒤, 1 / 1 조건부터 측정합니다.
Worker를 늘리는 명령과 Application이 사용할 코어를 늘리는 명령은 별개입니다. 두 값을 함께 바꾸고 실제 할당 상태를 확인합니다.
자리를 여덟 개 준비해도 이용자가 한 자리만 신청하면 모두 쓰지는 않습니다. Worker 수는 준비한 자원, 전체 Executor 코어 상한은 이번 프로그램의 사용 한도에 대응합니다.
실행 위치: 3장 실습 폴더의 PowerShell. 이전 실행의 APP_STOPPED를 확인한 뒤 다음 조건으로 넘어가세요.
--scale spark-worker=N: N은 추가 수가 아니라 유지할 Worker의 전체 수.docker compose up -d --scale spark-worker=1
docker compose ps -a측정 전 확인: Master UI에서 ALIVE Worker 1개와 Total Cores 1을 확인합니다. 등록이 완료되면 아래 측정 명령을 실행하세요.
docker compose exec -e TOTAL_EXECUTOR_CORES=1 spark-client bash /opt/spark/apps/run_performance.sh --end 1000000001 --partitions 128 --repetitions 3 --wait-seconds 0한 명령 안에서 세 번 계산합니다. RUN_1_SECONDS, RUN_2_SECONDS, RUN_3_SECONDS와 MEDIAN_SECONDS를 기록하세요.
docker compose up -d --scale spark-worker=2
docker compose ps -a
측정 전 확인: Master UI에서 ALIVE Worker 2개와 Total Cores 2를 확인합니다. 등록이 완료되면 아래 측정 명령을 실행하세요.
docker compose exec -e TOTAL_EXECUTOR_CORES=2 spark-client bash /opt/spark/apps/run_performance.sh --end 1000000001 --partitions 128 --repetitions 3 --wait-seconds 0시간과 검증 결과를 기록하고, 표 B에 쓸 실제 Executor 수도 확인하세요.
--wait-seconds 0만 --wait-seconds 300으로 바꿔 실행합니다.APP_STOPPED까지 기다린 뒤 다음 조건을 진행합니다.같은 서비스의 개수를 4로 맞춥니다. 자원 등록을 확인한 뒤 프로그램의 코어 상한도 4로 지정합니다.
docker compose up -d --scale spark-worker=4
docker compose ps -a
측정 전 확인: Master UI에서 ALIVE Worker 4개와 Total Cores 4를 확인합니다. 등록이 완료되면 아래 측정 명령을 실행하세요.
docker compose exec -e TOTAL_EXECUTOR_CORES=4 spark-client bash /opt/spark/apps/run_performance.sh --end 1000000001 --partitions 128 --repetitions 3 --wait-seconds 0세 번의 측정 시간, 중앙값과 검증 결과를 기록합니다.
Worker를 8개로 늘리고 전체 코어 상한도 8로 맞춥니다. 나머지 입력과 반복 조건은 그대로 유지합니다.
docker compose up -d --scale spark-worker=8
docker compose ps -a
측정 전 확인: Master UI에서 ALIVE Worker 8개와 Total Cores 8을 확인합니다. 등록이 완료되면 아래 측정 명령을 실행하세요.
docker compose exec -e TOTAL_EXECUTOR_CORES=8 spark-client bash /opt/spark/apps/run_performance.sh --end 1000000001 --partitions 128 --repetitions 3 --wait-seconds 0측정값과 검증 결과를 기록합니다. PC의 CPU·메모리가 부족해 조건을 실행하지 못했다면 미측정으로 남기고 오류와 환경을 기록합니다.
기본 입력의 예상 정답은 아래와 같습니다. 시간은 자신의 PC에서 측정해 기록하세요.
SUM_RESULT=500000000500000000
CHECK=PASS
UI observation: 0 seconds
APP_STOPPED| Worker / 요청 Core | 예상 Executor | 중앙값(초) | Speedup | 효율(%) |
|---|---|---|---|---|
| 1 / 1 | 1개 | 미측정 | 1.00 (기준) | 100 (기준) |
| 2 / 2 | 2개 | 미측정 | 계산 후 기록 | 계산 후 기록 |
| 4 / 4 | 4개 | 미측정 | 계산 후 기록 | 계산 후 기록 |
| 8 / 8 | 8개 | 미측정 | 계산 후 기록 | 계산 후 기록 |
Speedup ÷ Worker 수 × 100입니다. 이 표는 Worker마다 1 Core이고 Worker와 요청 Core를 함께 늘린 조건입니다.계산법을 익히는 가상 예시: Worker 1개일 때 20초, 4개일 때 10초라면 속도 향상은 20 ÷ 10 = 2배, 효율은 2 ÷ 4 × 100 = 50%입니다. 이 숫자는 실제 측정 결과가 아닙니다.
Worker를 4개로 늘렸지만 제출 옵션을 1 Core로 두면 표 A의 4 / 4 조건일까요? 아닙니다. Worker 제공량과 Application 코어 상한을 모두 확인해야 합니다.
출처: Spark Worker 확장과 성능 측정 2–4쪽, 단계 2–6과 결과표 A · Docker 공식 문서의 --scale 옵션.
다음 절로 이동할 조건: 표 A의 네 조건과 실제 2 / 2 Executor 수를 기록합니다. Worker는 8개를 유지하고, 마지막 실행의 APP_STOPPED 이후 전체 코어 상한만 2로 바꿉니다.
Worker는 여덟 개 유지하고 전체 Executor 코어 상한만 두 개로 줄입니다. 준비된 자원과 Application이 쓰는 자원을 비교합니다.
창구 여덟 개 중 두 곳에만 업무를 배정하면 나머지는 그 업무를 처리하지 않습니다. 이번 설정도 Executor마다 1 Core이므로 전체 2 Core 상한이 참여 수를 제한합니다.
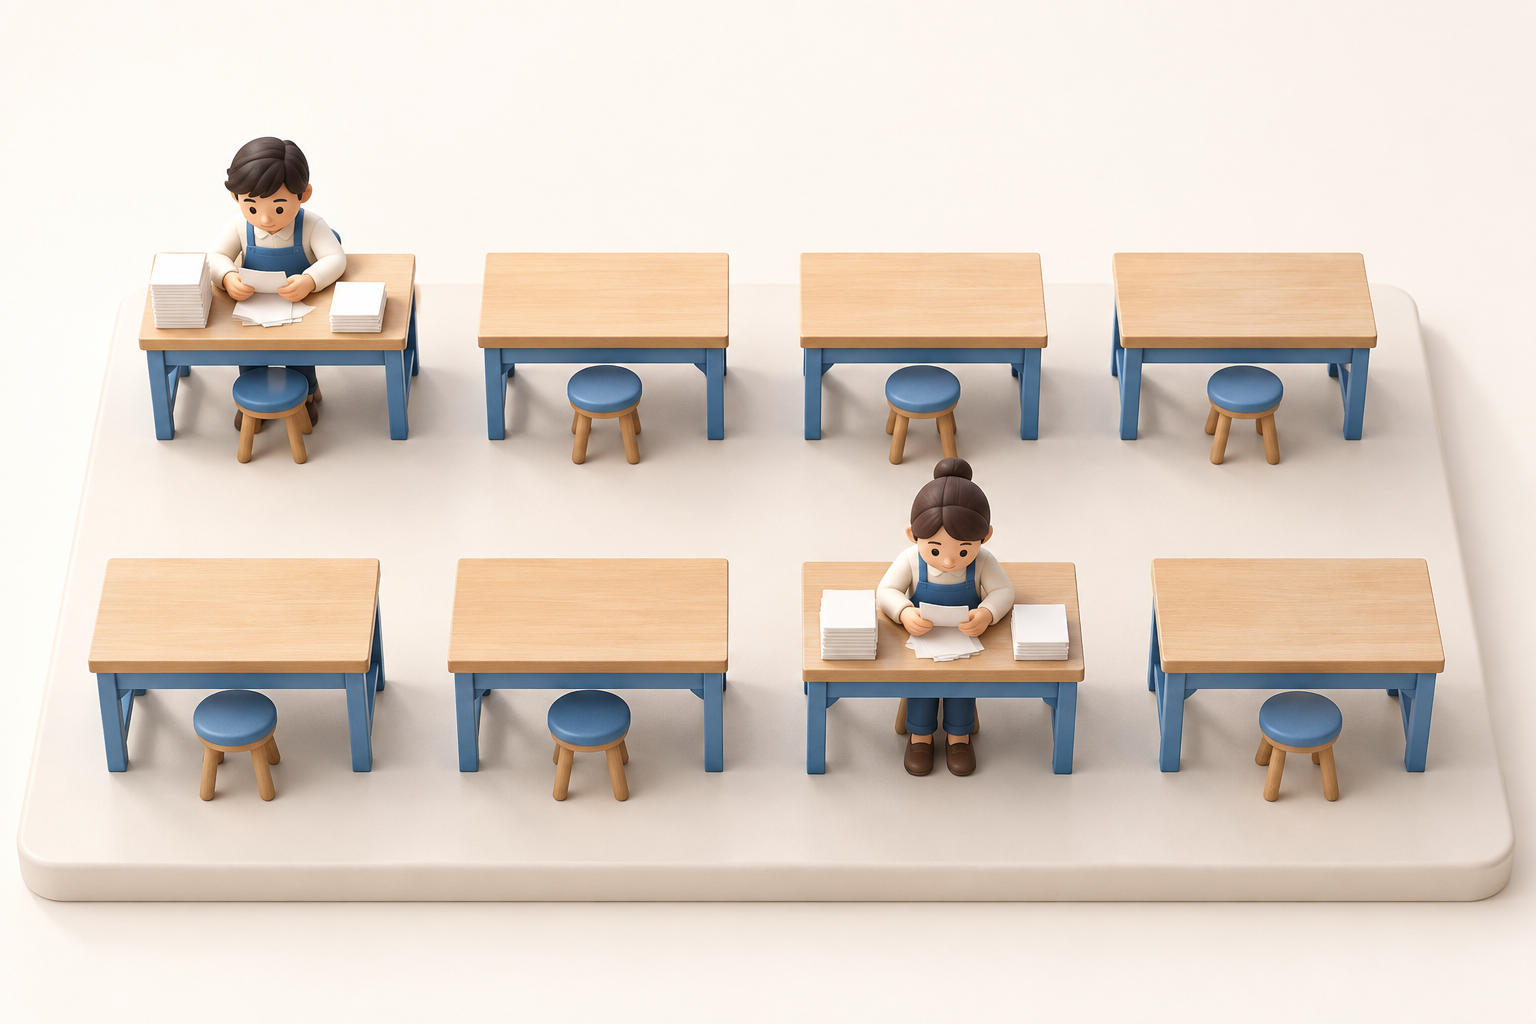
전체 코어 상한이 2이고 Executor 하나가 1 Core를 쓰므로, 이 Application에는 최대 두 Executor가 배정됩니다. 비어 있는 작업대처럼 나머지 Worker가 준비되어 있어도 자동으로 이번 계산에 참여하지는 않습니다.
실행 위치: 3장 실습 폴더의 PowerShell. Worker 8개가 등록되어 있고 이전 Application이 종료된 상태에서 실행합니다.
docker compose exec -e TOTAL_EXECUTOR_CORES=2 spark-client bash /opt/spark/apps/run_performance.sh --end 1000000001 --partitions 128 --repetitions 3 --wait-seconds 0학습용 모형은 자원 사용과 입력 Task의 동시 실행 상한을 보여 줍니다. 속도 예측은 아니며 최종 집계·통신 시간은 별도로 필요합니다.
첫 행은 앞 절에서 기록한 2 / 2 결과입니다. 둘째 행에는 방금 실행한 8 / 2 결과를 적습니다. 실제 Executor 수는 Driver 행을 제외해 기록합니다.
| Worker / 요청 Core | 실제 Executor | 중앙값(초) | 관찰 |
|---|---|---|---|
| 2 / 2 | 직접 확인 | 표 A의 2 / 2 결과 | 모두 참여하는지 확인 |
| 8 / 2 | 직접 확인 | 이번 실행값 기록 | 나머지 Worker가 이 Application 계산에 참여하는지 확인 |
관찰 대기만 300초로 바꾸는 보충 실행입니다. UI observation: 300 seconds가 보이면 Master UI와 Driver UI를 확인하고 APP_STOPPED까지 기다리세요.
docker compose exec -e TOTAL_EXECUTOR_CORES=2 spark-client bash /opt/spark/apps/run_performance.sh --end 1000000001 --partitions 128 --repetitions 3 --wait-seconds 300출처: Spark Worker 확장과 성능 측정 4쪽의 단계 7과 결과표 B, 6쪽 풀이 기준 · 제출 스크립트.
다음 절로 이동할 조건: 2 / 2와 8 / 2의 중앙값·실제 Executor 수를 표 B에 기록합니다. APP_STOPPED 뒤 Worker 8개를 유지한 채 이번에는 8 Core를 요청해 전체 자원 사용을 관찰합니다.
입력과 정답이 같은지 확인하고 실제 자원 사용을 기록해야 처리 시간을 비교할 수 있습니다. 여덟 Core 실행을 관찰해 표 A와 표 B의 결과를 해석합니다.
사람이 늘어도 통로와 작업대를 공유하면 기다림이 생깁니다. 이 실습도 한 PC의 CPU·메모리를 공유하므로 Worker 수만큼 빨라진다고 보장할 수 없습니다.
실행 위치: 3장 실습 폴더의 PowerShell. Worker 8개 상태에서 이전 실행 종료를 확인하고 진행합니다.
docker compose exec -e TOTAL_EXECUTOR_CORES=8 spark-client bash /opt/spark/apps/run_performance.sh --end 1000000001 --partitions 128 --repetitions 3 --wait-seconds 300UI observation: 300 seconds가 나오면 확인하세요.
계산 명령이 실행되는 동안 3장 실습 폴더에서 두 번째 PowerShell 창을 열고 아래 명령으로 컨테이너 상태를 관찰합니다. 같은 입력을 다시 관찰할 때도 앞 프로그램이 종료된 뒤 실행하세요.
docker compose statsUI observation: 300 seconds가 나온 뒤에는 계산이 끝나 대기 중입니다. 코어가 할당된 상태여도 CPU 사용률은 낮아질 수 있습니다.APP_STOPPED로 확인합니다.한 번만 확인하려면 docker compose stats --no-stream을 사용합니다. 작은 입력은 계산이 빨리 끝나 관찰 시점을 놓칠 수 있으므로, 측정값과 함께 언제 본 값인지 기록하세요.
관찰 방법: Docker 컨테이너 통계 · Spark 실행 모니터링. 자원 관찰 보충.
SUM_RESULT와 CHECK=PASS가 나왔는지 먼저 확인합니다. 정답이 다르면 속도 비교를 결론 내리지 않습니다.다른 문서에 복사해 직접 관찰한 값을 채우세요.
입력 end / partitions / repetitions:
PC와 Docker에 사용 가능한 CPU·메모리:
계산 중 CPU·메모리 사용과 관찰 시점:
조건별 RUN_1 / RUN_2 / RUN_3 / MEDIAN_SECONDS:
조건별 SUM_RESULT / CHECK:
Master의 ALIVE Worker / Total Cores / Used Cores:
Driver를 제외한 Executor 수와 Task 관찰:
표 A의 Speedup / 효율:
2 Worker·2 Core와 8 Worker·2 Core 비교:
8 Worker와 4 Worker 비교 및 가능한 이유:
오류 또는 미측정 조건:docker compose ps -a와 docker compose logs spark-worker 확인.TOTAL_EXECUTOR_CORES와 Master 자원 상태 확인.로그 명령은 보충 진단용입니다.
APP_STOPPED를 확인한 뒤 3장 실습 폴더의 PowerShell에서 실행합니다.
docker compose down
docker compose ps -a
확장 실습의 컨테이너와 네트워크가 제거되고 서비스 목록이 비었는지 확인합니다. 계산이 끝난 것과 실습 환경을 종료한 것은 서로 다른 단계입니다.
출처: Spark Worker 확장과 성능 측정 5–6쪽, 단계 8–10과 풀이 기준 · 성능 측정 코드.
보충 Worker 성능 비교에 전체 측정 코드, 제출 스크립트, Compose 설정과 빈 CSV 기록표가 있습니다. 작은 입력 확인부터 1·2·4·8 Worker와 Core 상한 비교까지 안내합니다.
보충 예제는 이 장과 실행 폴더·포트·기본 입력이 다릅니다. 해당 예제의 파일과 명령을 함께 사용하세요.